Le développement avec les grands modèles de langage (LLM) commence généralement par une simple boucle requête-réponse. Mais dès que la tâche dépasse le cadre d’un simple chatbot et exige du modèle qu’il effectue de véritables actions — comme l’intégration d’outils externes, l’interaction avec des bases de données ou l’accès au système de fichiers — nous nous heurtons à un défi fondamental. L’API standard d’un modèle est par nature sans état (stateless) et ne dispose pas de mécanismes intégrés pour gérer une logique complexe.
Une tâche en apparence simple comme « analysez ce fichier, trouvez les données pertinentes en ligne et générez un rapport » se transforme en un défi d’orchestration complexe :
- Comment gérer l’état et transmettre le contexte entre plusieurs appels au LLM ?
- Comment implémenter une logique cyclique, où un agent interagit de manière répétée avec des outils jusqu’à ce qu’un objectif soit atteint ?
- Comment standardiser les connexions à différents modèles (OpenAI, Gemini, locaux) et outils sans avoir à réécrire le code à chaque fois ?
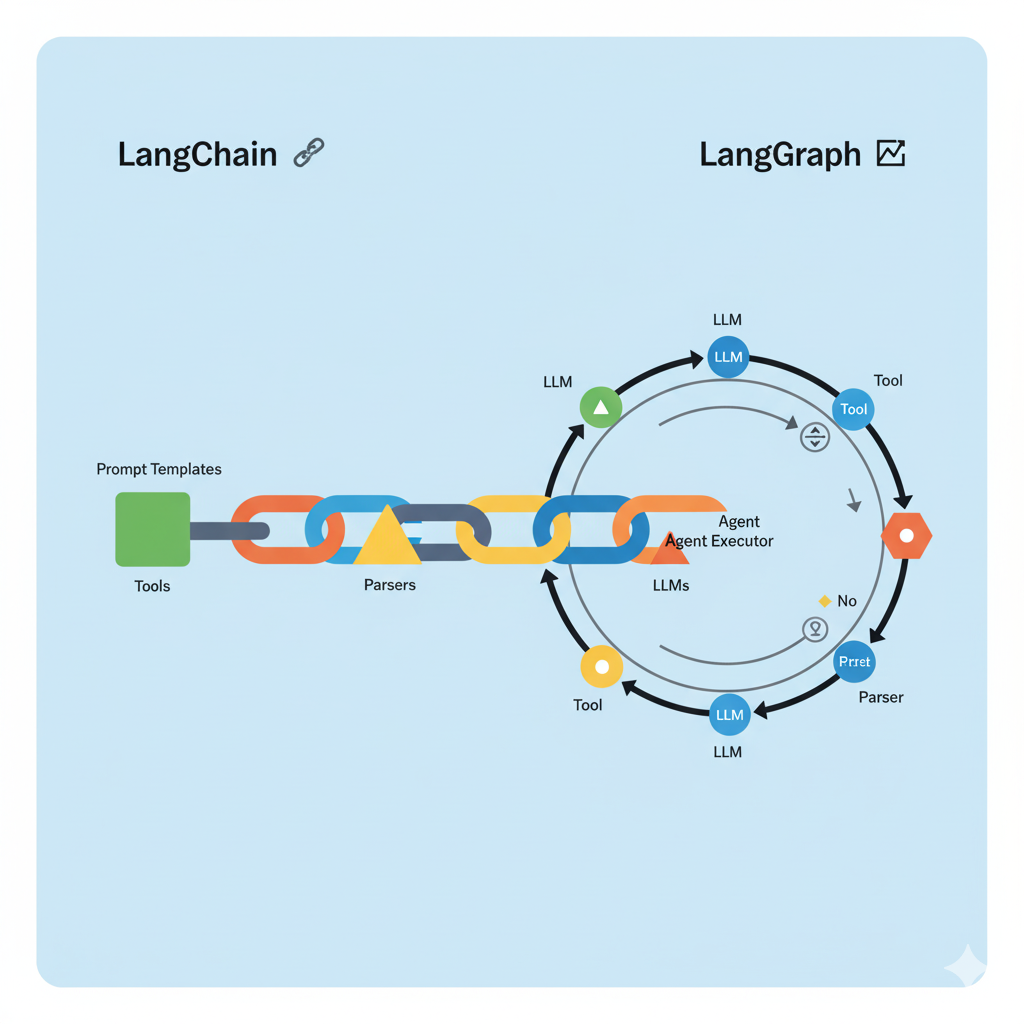
C’est pour simplifier le développement de tels systèmes et fournir aux développeurs une approche standardisée pour relever ce défi d’orchestration que LangChain et LangGraph ont été créés :
- LangChain fournit une boîte à outils unifiée : des interfaces standardisées pour les modèles, des composants pour les prompts et les outils.
- LangGraph est un framework construit sur LangChain qui permet de bâtir la logique décisionnelle de l’agent sous la forme d’un graphe d’états, résolvant avec élégance le problème des cycles et des branchements.
Pour mieux comprendre leurs rôles, utilisons une analogie.
Imaginez que vous construisiez quelque chose avec des LEGO. Vous avez des briques individuelles (moteurs, roues, blocs), mais en elles-mêmes, ce ne sont que des pièces. Pour assembler une machine fonctionnelle à partir de celles-ci, vous avez besoin d’instructions et d’une compréhension de la manière de connecter ces pièces.
Dans le monde des agents d’IA :
- LangChain est votre ensemble de briques LEGO high-tech.
- LangGraph est le manuel d’instructions avancé qui vous permet d’assembler ces briques non pas en modèles statiques, mais en mécanismes dynamiques et « intelligents » capables de prendre des décisions.
…
Analysons chacun de ces outils séparément.
Partie 1 : LangChain — La boîte à outils pour travailler avec les LLM
L’objectif principal de LangChain : simplifier et standardiser l’interaction entre votre code et les grands modèles de langage (LLM). Il fournit des composants prêts à l’emploi (« briques ») pour résoudre des tâches courantes.
Composants clés de LangChain (Nos « briques ») :
1. Modèles (Models)
Ce sont des wrappers pour une interaction directe avec les réseaux de neurones. LangChain les divise en deux types :
LLMs: L’ancienne interface. Prend une chaîne de caractères en entrée, renvoie une chaîne de caractères.- Exemple :
llm.invoke("De quelle couleur est le ciel ?")→"Le ciel est bleu."
- Exemple :
ChatModels: L’interface moderne et plus puissante. Travaille avec une liste de messages (HumanMessage,AIMessage,SystemMessage). Cela permet au modèle de mieux comprendre le contexte d’une conversation.- Exemple :
chat.invoke([HumanMessage(content="De quelle couleur est le ciel ?")])→AIMessage(content="Le ciel est généralement bleu...")
- Exemple :
LangChain unifie l’API. Vous n’avez pas besoin d’apprendre à travailler avec OpenAI, Gemini ou un Ollama local séparément. Vous remplacez simplement un objet comme
ChatOpenAIparChatGoogleGenerativeAIouChatOllama, et le reste de votre code continue de fonctionner.
2. Prompts
Ce sont des modèles pour vos requêtes au modèle. Au lieu d’assembler manuellement le texte de la requête à chaque fois, vous créez un modèle avec des variables.
from langchain_core.prompts import ChatPromptTemplate

template = ChatPromptTemplate.from_messages([
    ("system", "Vous êtes un assistant utile qui traduit le texte en {output_language}."),
    ("human", "{text_to_translate}")
])

prompt_value = template.invoke({"output_language": "français", "text_to_translate": "J'aime programmer."})
Les prompts rendent vos requêtes reproductibles, sûres et facilement modifiables. Vous séparez la logique de formation de la requête de la logique d’appel du modèle.
3. Chaînes (Chains et LCEL)
C’est le cœur du premier LangChain. Une chaîne est une connexion séquentielle de plusieurs composants. Aujourd’hui, on utilise pour cela le LangChain Expression Language (LCEL), qui ressemble à un pipe (|).
La chaîne la plus simple : prompt | model.
chain = template | get_gemini_llm()
response = chain.invoke({"output_language": "allemand", "text_to_translate": "Bonjour, le monde !"})
# response.content contiendra "Hallo, Welt!"
Les chaînes vous permettent de créer des flux de travail simples. Par exemple, d’abord obtenir des données de l’utilisateur, puis former un prompt, l’envoyer au modèle, et enfin, traiter la réponse.
4. Analyseurs de sortie (Output Parsers)
Les modèles renvoient du texte, mais dans les applications, nous avons souvent besoin de données structurées (JSON, une liste, un nombre). Les analyseurs convertissent la réponse textuelle « brute » du modèle au format souhaité.
from langchain_core.output_parsers import JsonOutputParser

# ... créer un prompt qui demande au modèle de répondre au format JSON
parser = JsonOutputParser()
chain = template | get_openai_llm() | parser

# Maintenant, chain.invoke(...) ne renverra pas un objet texte, mais un dictionnaire Python (dict)
Pour que votre code puisse travailler de manière programmatique avec le résultat. Au lieu d’essayer d’extraire les données nécessaires d’une chaîne de caractères, vous obtenez directement un objet prêt à l’emploi.
5. Outils (Tools)
C’est ce qui donne des « mains » au modèle. Un outil est n’importe quelle fonction qu’un agent peut appeler. Cela pourrait être :
- Une recherche sur Internet (
TavilySearch,BraveSearch). - Une calculatrice.
- Une fonction pour lire un fichier sur le disque.
- Un appel à votre API interne.
Un modèle ne sait pas par lui-même quel temps il fait aujourd’hui ou ce qui est écrit dans votre fichier
rapport.docx. Les outils sont le seul moyen pour lui d’accéder à des informations externes et d’effectuer des actions dans le monde réel.
Partie 2 : LangGraph — L’orchestrateur pour la création d’agents
Si LangChain est l’ensemble des pièces, alors LangGraph est le système de contrôle qui décide quelle pièce utiliser et à quel moment.
Le problème que LangGraph résout : Les chaînes classiques dans LangChain sont linéaires. Elles vont d’un point A à un point B. Mais les vraies tâches ne sont pas linéaires. Elles nécessitent des cycles, des branchements et des prises de décision.
Par exemple, un agent de recherche doit :
- Comprendre la requête.
- Décider : Une recherche sur Internet est-elle nécessaire ?
- Si oui → utiliser l’outil de recherche.
- Analyser les résultats.
- Décider : Les informations sont-elles suffisantes ?
- Si non → retourner à l’étape 3 avec une requête affinée (c’est un cycle).
- Si oui → générer la réponse finale.
Une logique aussi complexe ne peut pas être décrite avec une simple chaîne.
L’idée centrale de LangGraph : représenter le fonctionnement d’un agent comme un graphe d’états (ou un organigramme).
Composants clés de LangGraph (Éléments de l’organigramme) :
1. État (State)
C’est la mémoire centrale de tout le processus. Il s’agit généralement d’un dictionnaire Python (TypedDict) qui est passé d’une étape à l’autre. Chaque étape peut y lire des données et y écrire de nouvelles données.
Exemple d’état :
{"user_request": "...", "search_results": [], "final_answer": None}.
2. Nœuds (Nodes)
Ce sont les blocs d’actions de votre organigramme. Chaque nœud est une fonction Python qui :
- Prend l’
étatactuel en entrée. - Effectue une action (appelle un LLM, utilise un outil).
- Renvoie l’
étatmis à jour.
Exemples de nœuds :
call_model_node,execute_tool_node,analyze_results_node.
3. Arêtes (Edges)
Ce sont les flèches qui relient les nœuds. Elles déterminent quel nœud sera exécuté ensuite. Il existe deux types d’arêtes :
- Arêtes normales : Relient simplement le nœud A au nœud B. Une fois A terminé, B sera toujours exécuté.
- Arêtes conditionnelles (
Conditional Edges) : C’est la partie la plus importante. Après le nœud A, une fonction spéciale de « routage » est exécutée, qui examine l’étatactuel et décide où aller ensuite : vers le nœud B, C ou D.
Exemple d’arête conditionnelle :
- Après avoir appelé le modèle (le nœud
agent_node), nous vérifions l’état.- Si la réponse du modèle inclut un appel d’outil → nous allons au nœud
execute_tool_node.- S’il n’y a pas d’appel d’outil → nous allons au nœud final
END.
LangChain vs. LangGraph : Quand utiliser quoi ?
| Critère | LangChain (Chaînes LCEL) | LangGraph |
|---|---|---|
| Cas d’utilisation principal | Tâches simples et linéaires | Tâches complexes et cycliques (agents) |
| Structure | Pipeline (A → B → C) | Graphe (organigramme avec branchements et cycles) |
| Flux de contrôle | Déterministe, prédéfini | Dynamique, déterminé à l’exécution |
| Exemple de tâche | 1. Prendre un texte. 2. Le résumer. 3. Le traduire dans une autre langue. | 1. Recevoir une question. 2. Chercher sur Internet jusqu’à trouver une réponse. 3. Synthétiser les résultats et répondre. |
| Analogie | Une chaîne de montage dans une usine | Une équipe de personnes qui délibèrent et prennent des décisions |
Assemblons le tout
- L’entrée de l’utilisateur arrive dans l’État initial de LangGraph.
- Le Nœud « Agent » reçoit l’état. À l’intérieur de ce nœud se trouve une chaîne LangChain (
prompt | model | parser). Le modèle, en utilisant les Outils de LangChain, décide de la prochaine action (par ex., « appeler la recherche »). Sa décision est inscrite dans l’État. - Une Arête Conditionnelle analyse l’état et dirige le flux vers le Nœud « Exécuteur d’Outils ».
- Ce nœud effectue l’appel réel de l’outil (par ex., une recherche web) et inscrit le résultat dans l’État.
- Le flux retourne au Nœud « Agent » (c’est un cycle). Le modèle voit maintenant le résultat de la recherche et prend une nouvelle décision.
- Le cycle se répète jusqu’à ce que le modèle décide que la tâche est terminée. L’Arête Conditionnelle dirigera alors le flux vers la fin.